토큰을 생성하는 것 뿐인데 느린 이유는 뭘까요?
태그: aws, fastapi
AWS LightSail
FE는 NextJS로 작성을 하였고 vercel을 통해서 배포를 했습니다. 서버 같은 경우 python framework인 fastAPI를 활용했습니다. 서버 환경은 AWS의 EC2를 활용하기로 했습니다. 하지만 서버 로직이 그렇게 어렵지 않고 간단한 I/O 작업만을 수행하는 경우가 대부분이어서 서버 환경을 간단하게 설정할 수 있는 AWS의 LightSail을 활용했습니다.
우선 서버 환경 구축은 해당 교재의 내용을 참고해서 거의 그대로 진행을 했습니다.
저희는 단순한 I/O 작업 뿐만 아니라, 사용자가 작성한 답변을 분석해서 그에 맞는 mbti를 서버에서 보내주어야 했습니다. 이를 위해서 LLM 모델을 활용했습니다. LLM 모델 중 Kcelectra를 활용했습니다. 로컬 환경에서 ChatGPT 프롬프트를 통해 사전 학습 데이터를 생성했습니다. 이후 학습이 완료된 모델을 LightSail에 함께 올려서 같은 인스턴스 환경에서 서버 구동과 모델 실행을 함께 하도록 구성했습니다.
LightSail?
아마존 Lightsail은 AWS에서 만든 가상 프라이빗 서버 (VPS) 입니다.
프로젝트를 빠르게 시작하는 데 필요한 가상머신(compute), SSD기반 스토리지, Networking, 로드밸런서, DNS관리, 고정IP, OS, 개발플랫폼(MEAN, Node.js 등), 어플리케이션(Wordpress, Nginx, GitLab, Redmine 등) 등 모두 포함하고 있습니다.
따라서 웹서비스를 빠르고 쉽게 구축하는데 특화되어 있는 서비스입니다. 그리고 무엇보다 EC2, RDB 등 개별 서비스를 따로 설정해서 사용하는 것보다 이 Lightsail 하나의 서비스로 웹서버를 운용하는데저렴합니다.
정리하자면, 라이트세일은 기존 EC2에 비해 저렴한 비용과 웹 서비스에 필요한 주요 기능들을 한 곳에서 쉽게 관리할 수 있게 구성된 입문자용 서비스입니다.
토큰 생성에 유난히 오래 걸리는 시간?
해당 페이지에서 10번 중 1번 꼴로, 혹은 동시에 접속 중인 유저가 너무 많은 경우, **TEST 시작하기** 버튼을 클릭해서 서버에 토큰 생성을 요청하는 작업에서 오랜 시간이 소요 되었습니다. 단순 성별과, 닉네임 정보를 토대로 토큰 정보 만을 요청하는 단계에서 생각보다 오랜 시간이 소요되고 있었고, 해당 문제의 해결 필요성을 느꼈씁니다.
저희가 예상한 문제는 총 3가지 였습니다.
- 프런트에서 발생하는 메모리 누수
- Lightsail의 메모리 부족
- web 서버를 동작하는 gunicorn의 설정 변경.
1번 프런트에서 발생하는 메모리 누수
화면 단에서 문제가 발생한다면, 모든 유저에게서 공통적으로 발생을 해야 한다고 생각했습니다. 이를 확인하기 위해 관리자 도구의 메모리 탭, 성능 탭을 통해 확인해 보았습니다.
우선 메모리 텝을 통해 메모리 점유율을 살펴보았습니다. 초기에 새로고침을 통해 compile code 전체를 새로 불러오는 과정 이후에는 메모리를 거의 사용하지 않고 있는 것을 확인할 수 있었습니다.

성능 탭에서 mbtmi 테스트를 진행할 경우 힙 사용 요소에도 문제가 없는 것으로 해석했습니다.
2번 Lightsail 메모리 부족
현재 lightSail의 메모리 사용량과 여유 메모리를 확인해 보았습니다. 현재 gunicorn을 가동하고 있는 상황에서 서버의 메모리 사용치를 확인해 보았습니다. atop 도구를 활용해서 서버 메모리를 확인했습니다.
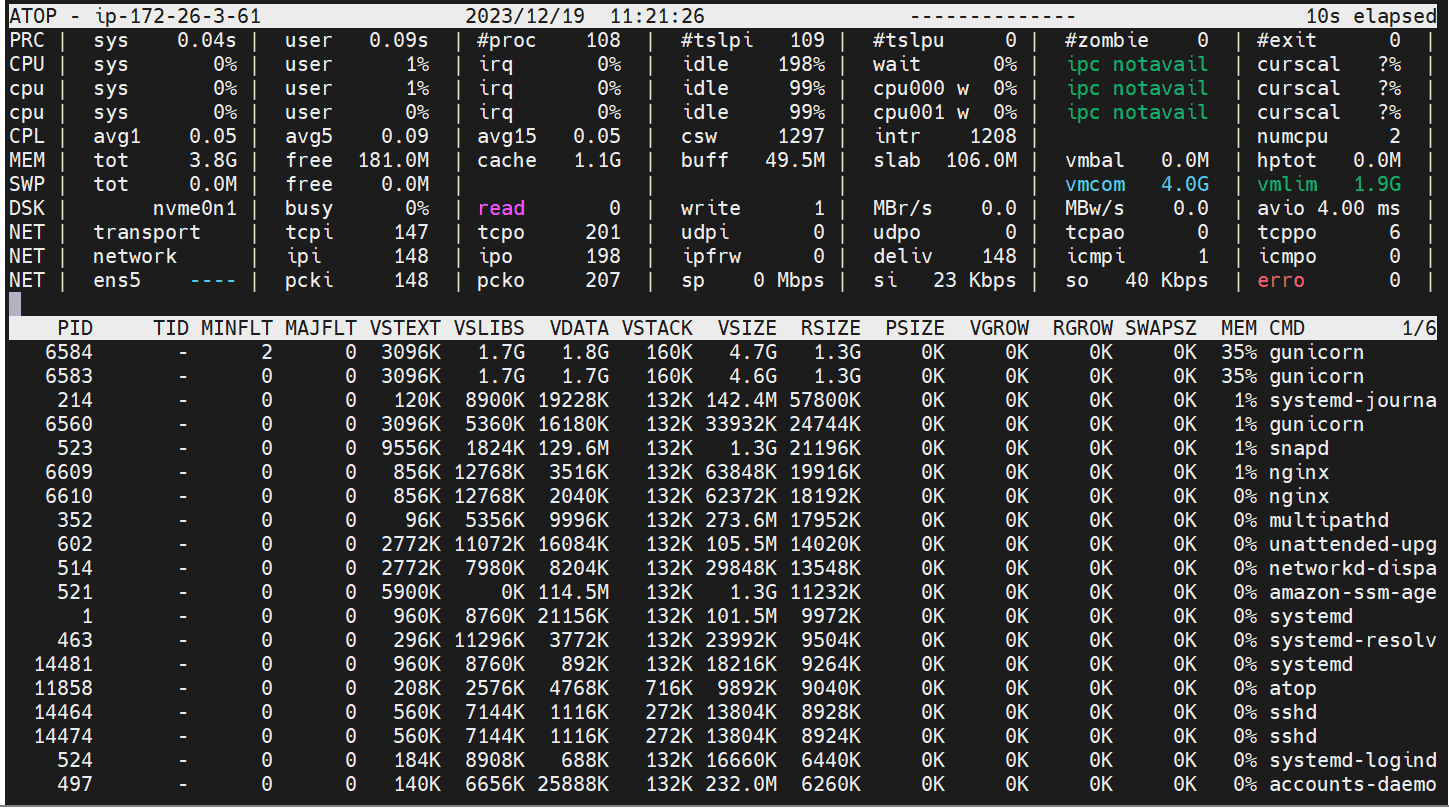
현재 메모리를 3.8G를 사용하고 있어고 남은 여유 메모리 공간은 181M 밖에 안되는 상황이었습니다. 따라서 REM 크기가 더 높은 lightsail로 이전을 실행했습니다.
3번 web 서버를 동작하는 gunicorn의 설정 변경.
다음으로 gunicorn에서 정보를 처리하는 과정에서 속도가 느린 것은 아닌가 하고 확인해 보았습니다. 이를 위해 먼저 gunicorn의 worker process와 thread에 대한 이해가 필요했습니다.
우선 gunicorn은 WSGI HTTP 서버로, Python 웹 애플리케이션을 병렬로 처리할 수 있는 Pre-fork 워커 모델을 지원합니다. gunicorn과 uvicorn을 함께 사용하면, FastAPI 애플리케이션을 여러 작업자로 분산하여 처리하고, 동시에 다수의 HTTP 요청을 빠르게 처리할 수 있습니다. (공식 FastAPI 문서에서도 권장하는 설) 이를 통해 uvicorn의 단점을 Gunicorn으로 보완하고 서버의 성능을 더욱 향상시킬 수 있습니다.
-
worker process fastapi 작업에서 CPU 관련 작업일 때 worker process의 개념이 중요합니다. CPU와 연관된 작업이 많을 경우, 이를 빠르게 처리 하기 위해서 worker process의 개수를 증가하는 것이 중요합니다. 공식 문서에서 추천하는 worker의 개수는 다음과 같습니다.
**(2~4) x $(NUM_CORES)** -
thread 스헤드는 하나의 프로세스 내에서 동시에 진행되는 작업 갈래, 흐름의 단위 입니다. 크롬 브라우저에서 파일을 다운 받으며, 유튜브를 볼수 있는 것은 모두 thread 덕분입니다. 이러한 상황에서 저희는 gunicorn에서 thread를 하나만 사용하고 있는 상황이었습니다. 즉 다른 유저의 I/O 작업을 수행하고 있는 경우 다른 유저의 I/O 작업은 앞선 작업이 끝날 때 까지 멈춰 있어야 했습니다.. 해당 문제를 해결하기 위해 thread의 개수 또한 확대했습니다. 공식문서에서 추천하는 threaf의 개수 또한 worer process를 지정하는 방법과 동일했습니다.
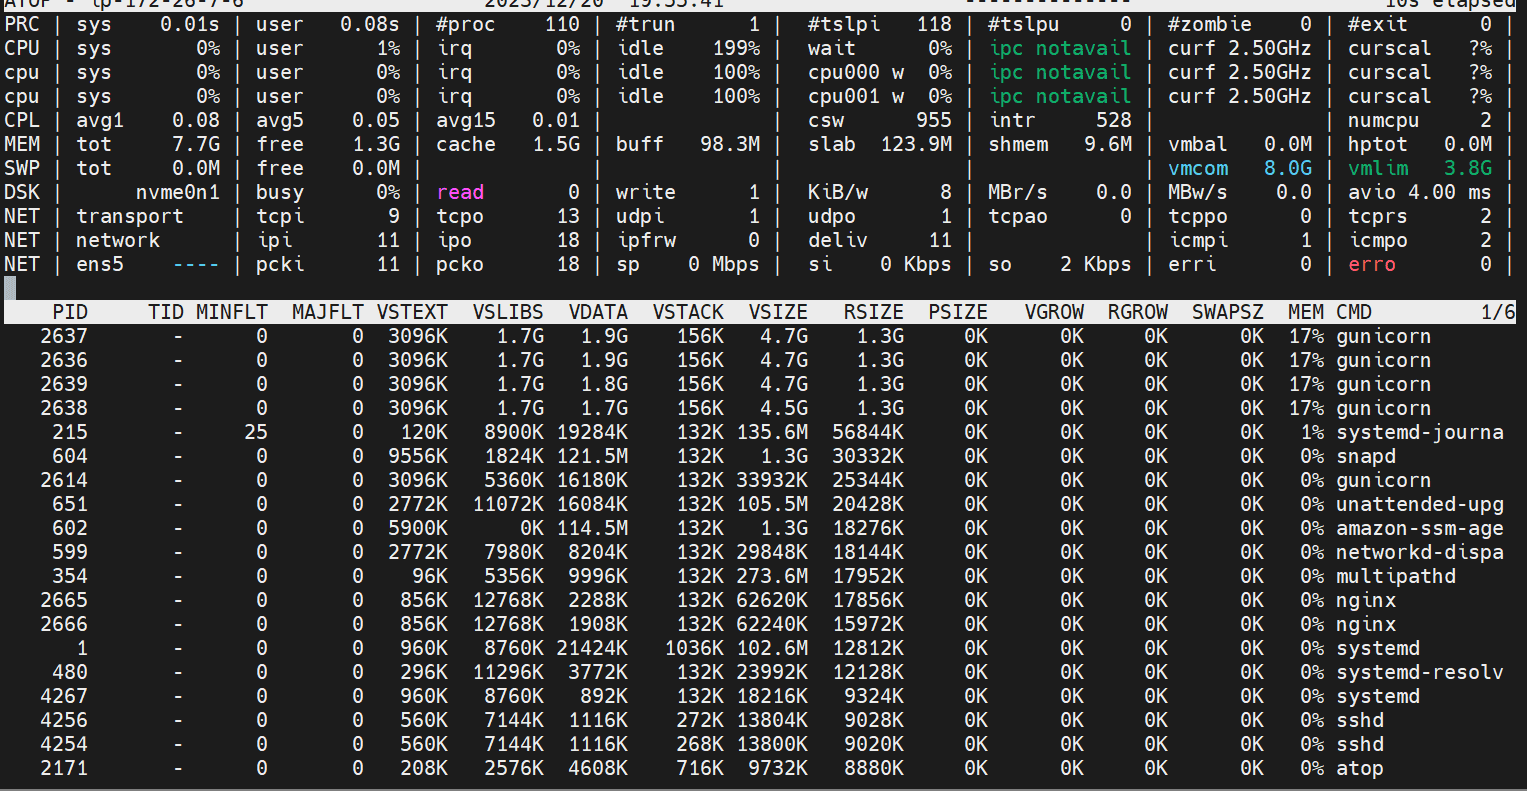
**(2~4) x $(NUM_CORES)**해당 문제를 반영해 다음과 같이 gunicorn의 설정을 변경했습니다. worker의 개수는 4개, thread의 개수는 6개로 설정하여 서버의 성능을 확장했습니다.[Unit] Description=gunicorn daemon After=network.target [Service] User=ubuntu Group=ubuntu WorkingDirectory=/home/ubuntu/projects/server ExecStart=/home/ubuntu/venvs/mbtmi/bin/gunicorn \ main:app \ --workers 4 \ --worker-class uvicorn.workers.UvicornWorker \ --threads=6 \ --bind unix:/tmp/mbtmi.sock \ [Install] WantedBy=multi-user.target해당 worker를 적용한 후 lightsail의 메모리를 확인했을 때 다음과 같이 메모리를 사용하는 것을 확인할 수 있었습니다.
Reference
- AWS LightSail
- - LightSail?
- 토큰 생성에 유난히 오래 걸리는 시간?
- Reference